Python PDF 库对比 2026:6 个库在同一批文件上的实测
Python PDF 库对比 2026:6 个库在同一批文件上的实测
用 pypdf 读一份 PDF,十分钟就能跑通。需求一多就麻烦了:先取出第一页的汇总表,再删掉附录,接着导出一份可编辑的 Word,最后给归档文件加密码。每一步在 Python 里都有成熟的方案,但很少出自同一个包。
本文在同一批测试文件上比较六个选项:pypdf、pdfplumber、PyMuPDF、pikepdf、reportlab 和 Spire.PDF for Python。需要说明的是,Spire.PDF 是 E-iceblue 的商业产品,本文由 E-iceblue 发布,测试也由发布方完成。为方便复现,测试夹具、版本和计时方法都写在文末的“测试方法”一节。下面的每个开源库,在它擅长的任务上都是合理的选择。
快速导航
- 如何选择 Python PDF 库
- 五个开源 Python PDF 库各自擅长什么
- 多库组合的 PDF 流程为什么越来越难维护
- Spire.PDF for Python 在 PDF 工作流中补上了什么
- Python 中的多步骤 PDF 工作流
- 性能与安装体积
- 免费版、评估版、临时授权与商业授权
- 为你的项目选对 PDF 库
- 常见问题
- 测试说明
1. 如何选择 Python PDF 库
任务只有一类时,直接选对应领域的专用库即可。本文的开源库各有专长;Spire.PDF 面向的是另一种情形:同一份文档要依次经过提取、编辑、转换和加密,而你希望维护一个 SDK,而不是三个库。
| 库 | 适用场景 | 需要留意 | 授权 |
|---|---|---|---|
| pypdf | 纯 Python 的页面合并、拆分、旋转与加密 | AES 加密需要 pypdf[crypto] |
BSD-3 |
| pdfplumber | 版面分析、表格提取、可视化调试 | 定位于读取,不用于修改页面 | MIT |
| PyMuPDF | 高速文本提取与页面渲染 | AGPL-3.0 或商业授权,需按分发方式评估 | AGPL-3.0 或商业 |
| pikepdf | 底层结构操作、线性化、加密 | 不提供文本提取 API | MPL-2.0 |
| reportlab | 用代码生成 PDF | 仅负责生成 | BSD |
| Spire.PDF | 提取、编辑、转换、加密混合任务,一个 SDK 完成 | 商业授权,提供免费版、评估版与临时授权 | 商业 |
读这张表时,按任务对号入座,不必按名字挑。如果你的流程只需要某个库第一列里的那一项操作,剩下要权衡的就只有第三列。在几个候选相差不大时,授权条款和安装体积往往是决定因素,后文会给出这两项的具体数字。
范围说明:本文只涵盖五个选定的开源库和一个商业 SDK,并未覆盖 Python 生态中所有专用 PDF 工具。
2. 五个开源 Python PDF 库各自擅长什么
搜索“Python PDF 解析库”或“Python PDF 读取库”的人,通常指的是两类需求:一类是从现有文件里取出文本和表格,另一类是改动文件本身的结构。下面五个库大致沿着这条线分工:读取方向,pdfplumber 和 PyMuPDF 更强;页面结构方向,pypdf 和 pikepdf 更合适;从零创建文档,则是 reportlab 的领域。每个库下面依次给出它的定位、我们的实测数据和能力边界。
pypdf
pypdf 是纯 Python 实现,主要做页面级操作,在干净环境中安装后体积为 1.8 MB。在我们的测试中,它提取 10 页文本用时 43.1 ms,旋转一页 9.2 ms,删除一页 8.6 ms,合并两个文件 14.7 ms,拆出三页 10.2 ms,AES-256 加密 19.6 ms。AES 需要安装 pypdf[crypto],体积随之增至 13.2 MB。如果你主要调整页面顺序、又不想引入编译依赖,它是顺手的首选;AES 加密会通过上面的 crypto extra 引入 cryptography。
1 | from pypdf import PdfReader, PdfWriter |
这段代码合并两个文件,旋转首页,并写出受 AES-256 保护的副本。
pdfplumber
需要看清页面版面时,pdfplumber 是合适的工具。它暴露字符、线条和矩形的坐标,因此表格提取与可视化调试都很方便。测试文件中带边框的 21 × 4 表格用时 44.6 ms;10 页纯文本提取为 320.4 ms,比专注文本的读取库耗时更长;同时,该库也暴露了版面分析和表格提取所依赖的位置信息。一页中文发票的提取用时 7.7 ms,并命中了预期短语“发票编号”。它只读取、不修改 PDF,通常要搭配另一个库使用。
1 | import pdfplumber |
调用返回第一页的第一个表格,格式是按行组织的列表。
PyMuPDF
PyMuPDF 基于编译引擎,同时覆盖文本处理和页面渲染。本次测试中它的文本提取最快,10 页只要 7.2 ms;删除一页 3.0 ms;150 DPI 渲染一页 48.8 ms。默认安装连同依赖共 201.3 MB(--no-deps 为 104.5 MB),是几个库里最大的,授权为 AGPL-3.0 或商业授权。如果你的服务要批量生成缩略图,或者要处理大量页面的文本,这些数字说明了它为什么常被选用。
1 | import pymupdf |
代码读取首页文本,并保存一张 150 DPI 的 PNG。
pikepdf
pikepdf 封装了 QPDF,直接操作 PDF 的对象结构。因此它适合旋转或删除页面(6.4 ms 和 5.8 ms)、重排页面(6.5 ms)、使用 revision 6 加密处理器做 AES-256 加密(32.0 ms),以及保存面向网页传输的线性化文件(7.8 ms)。它没有文本提取 API,所以团队通常会再配一个读取库。当你需要底层 PDF 对象操作、页面重排、加密或线性化时,可以优先考虑它。
1 | import pikepdf |
代码把首页设置为 90 度旋转并保存。
reportlab
reportlab 的职责是创建 PDF,对字体、坐标和流式版式都有完整的控制。测试中,生成一份 10 页文档(每页 40 行,Arial 10 pt)用时 14.1 ms。它不负责读取或编辑已有文件,这是清晰的定位,并不是缺陷:发票、标签和程序化报表正是它的用武之地。
1 | from reportlab.lib.pagesizes import A4 |
循环生成 10 页 A4 文件,每页 40 行。
3. 多库组合的 PDF 流程为什么越来越难维护
上面这些库本身都没有问题。麻烦出在同一个需求要按顺序用到好几个库的时候,每多一个工具,就多出一些单项测试里看不到的成本:
- 转换需要独立的转换器。 PDF 转 Word 不在上述读取和页面编辑库的能力范围内,需要另外引入,而且版面保真度要逐个文件验证。
- 页内文字的原地修改是另一回事。 页面操作针对整页的移动和删除,要改页面里的文字,得用别的方案。
- 复杂表单要另算。 读取简单字段是一回事,创建和扁平化表单是另一回事,各库能走多远并不相同。
- 签名和 PDF/A 需要额外工具。 归档与签名流程通常要再引入新的包。
- OCR 本来就要外接引擎。 扫描页需要这些库之外的识别引擎。
不妨想象一个典型的胶水脚本:在一个库里打开文件,写出中间文件,再用第二个库重新打开并保存,最后交给转换器第三次解析。每一次交接,字体、页面边框或加密标志都有可能发生变化,每一处都需要单独测试。这些代码写起来并不难,难的是需求一变,这部分总在不断膨胀。
这五点背后是同一类开销:多学一套 API,多一棵依赖树,多一张兼容性矩阵,多一条错误处理路径,工具之间还要来回传文件。
授权也值得单独说一句。常用的转换库 pdf2docx 采用 MIT 许可,但它依赖的 PyMuPDF 是 AGPL-3.0 或商业授权。这是两件独立的事,分发产品时两者都需要评估。想进一步了解读取环节,可以参考我们的 Python 解析 PDF 指南。
4. Spire.PDF for Python 在 PDF 工作流中补上了什么
Spire.PDF for Python 是商业 SDK,读取、编辑、转换、安全设置和生成都在一个包里完成。对比时有四个方面值得看。
1. 共享的文档模型与一致的 API
共享的文档模型加上一致的 Python API,让开发者在同一个 SDK 内完成多种 PDF 操作。像 PdfTableExtractor 这样的专用辅助类,直接作用于已加载的 PdfDocument。同一个已加载的 PdfDocument 可以用于多项操作,不需要在多个库之间传递中间 PDF 文件。升级时,需要跟踪的也只有一套错误处理方式和一组版本约束。
2. 基准测试中的表格提取性能
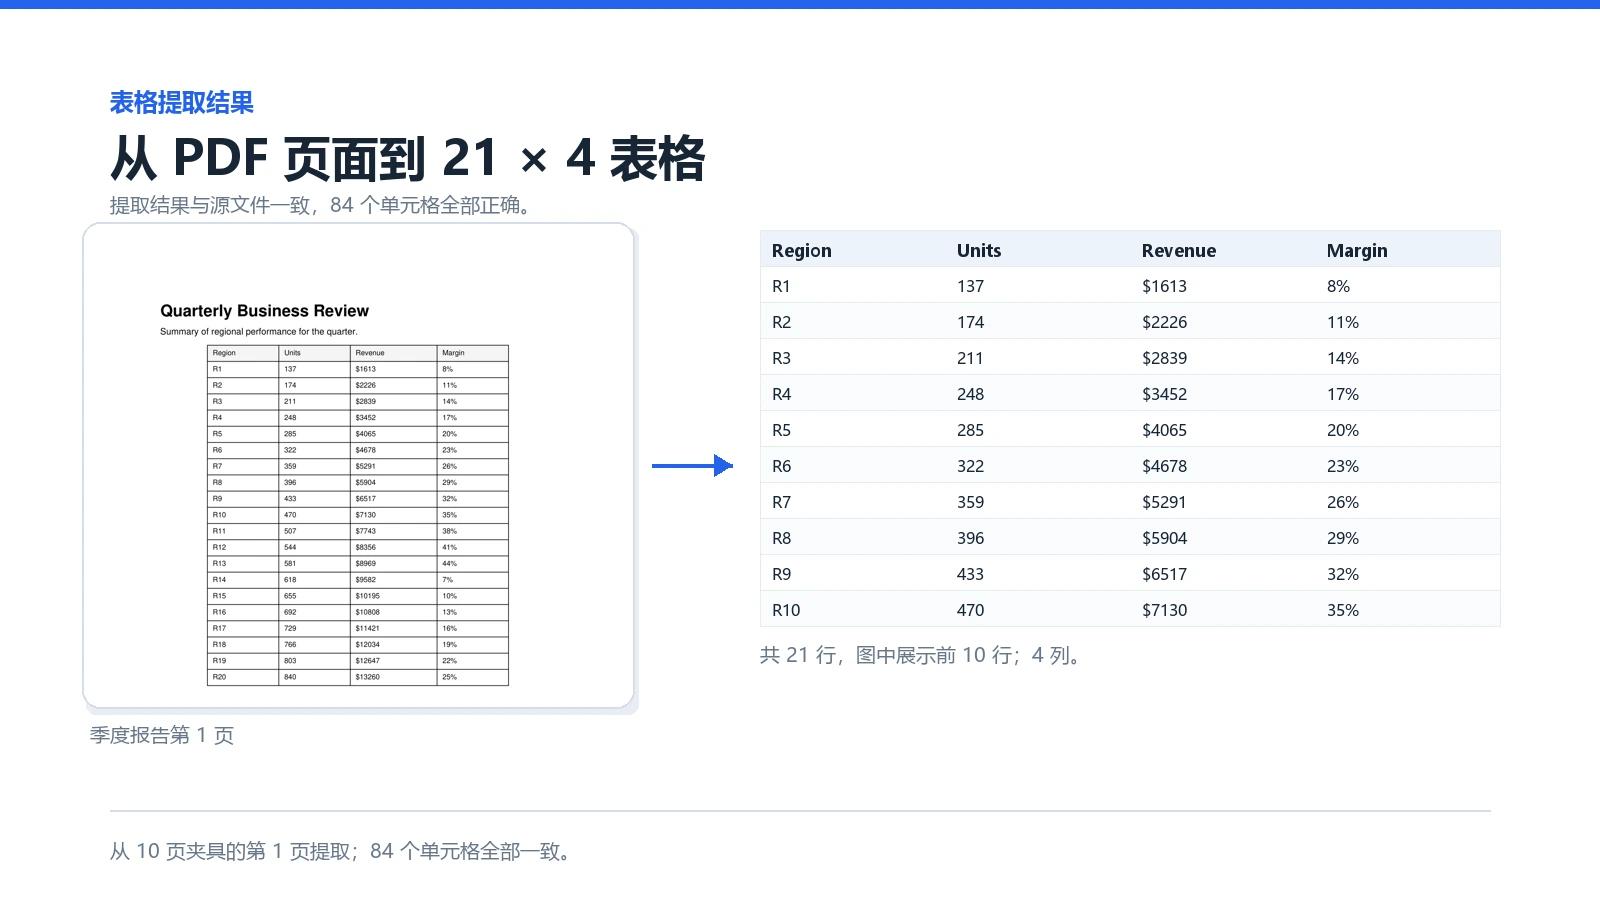
我们让三个库处理同一个带边框的表格。测试文件是 21 行 × 4 列,边框清晰,没有合并单元格。官方文档指出,表格提取在格式清晰的表格上效果最好,因此下面的结果只代表这类表格。
| 库 | 中位数 | 区间 | 结果 |
|---|---|---|---|
| Spire.PDF | 18.9 ms | 16.2 到 26.4 ms | 21 × 4,84 个单元格全部正确 |
| pdfplumber | 44.6 ms | 42.3 到 53.7 ms | 21 × 4,84 个单元格全部正确 |
| PyMuPDF | 363.4 ms | 341.6 到 385.7 ms | 21 × 4,84 个单元格全部正确 |
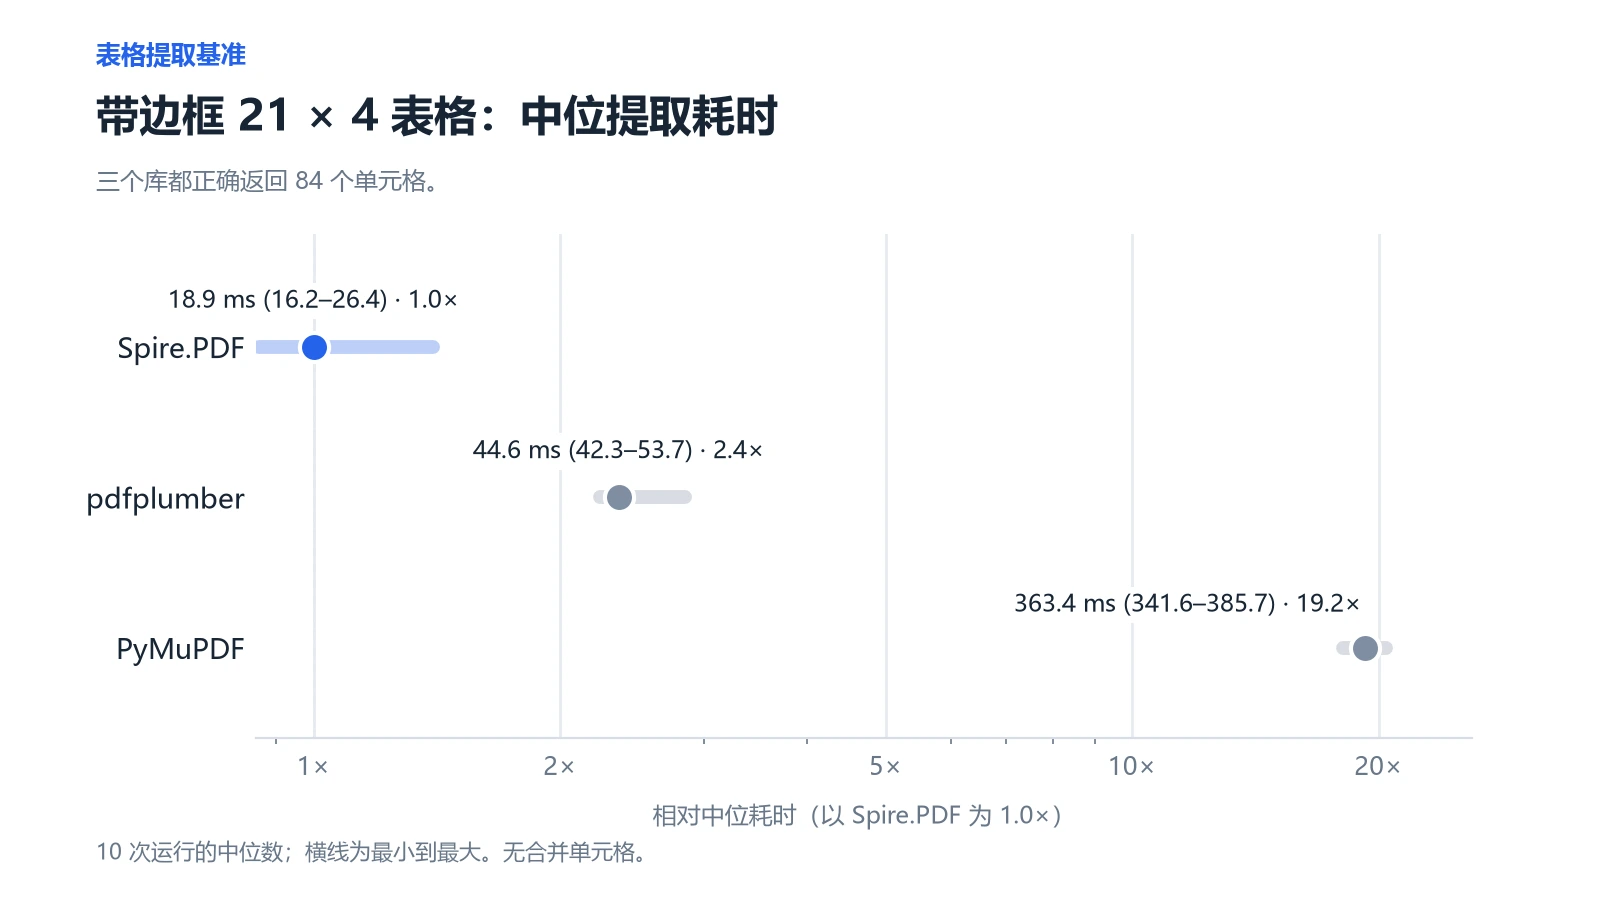
三个库返回的单元格内容完全一致,所以这里比较的是正确性相同前提下的耗时。Spire.PDF 在本次测试中中位数最低。含合并单元格、无边框的表格和扫描页都不在测试范围内,结果可能不同。这套 API 的完整用法见 Python 提取 PDF 表格数据。
3. 表单
Spire.PDF for Python 文档提供了创建、填充表单域以及把表单扁平化为静态内容的 API。表单处理未纳入本次性能测试,因此这一节只描述文档所述的能力。
4. 导出为其他格式
同一个已加载的文档可以保存为多种格式。下表是我们在一份 10 页报告上实际产出过文件的格式。
| 方向 | 验证深度 |
|---|---|
| PDF 转 DOCX、HTML、Markdown | 已产出,文本内容已检查 |
| PDF 转 XLSX | 已产出,单元格内容存在,结构取决于源文件版面 |
| PDF 转 PNG、XPS、SVG、PPTX | 已产出,视觉保真度取决于源文件版面 |
| PDF 转 PDF/A-1a、PDF/A-1b | 转换方法可用,已产出并核对 XMP 标识;未经过外部 PDF/A 合规验证 |
转换结果取决于源文件的版面,用于生产前请先拿有代表性的文件验证。DOCX 这条路径的细节,可以看教程 Python 将 PDF 转为 Word。
5. Python 中的多步骤 PDF 工作流
为了把维护成本落实到代码上,我们设计了一个常见任务:一份 40 页的季度报告,需要提取摘要表、删除附录页,再从修改后的文件产出两个结果,一份可编辑的 DOCX 和一份 AES-256 加密的 PDF 归档件。
1 | 原始 PDF(40 页) |
开源方案用 pdfplumber 提取表格,用 pypdf[crypto] 删页并加密,用 pdf2docx 生成 Word 副本。直接处理 PDF 的包有 3 个。在干净环境中一起安装后,共 29 个分发包、388.9 MB;按同样口径,Spire.PDF 为 70.5 MB。
用 Spire.PDF 时,整个流程都围绕同一个文档对象:
1 | from spire.pdf.common import * |
为保证同口径对比,两套实现都在这份报告的 10 页版本上运行。三个开源包合计的中位总耗时为 1,346.2 ms,Spire.PDF 为 267.3 ms。两边都正确提取了全部 84 个表格单元格,也都生成了 9 页的加密 PDF,并能用密码重新打开;两份归档件在没有密码时都无法打开。40 页版本中,开源方案耗时 3,241.4 ms,输出 39 页;评估版的 Spire.PDF 只处理前 10 页,因此不拿这一组做对比(见后文的版本说明)。
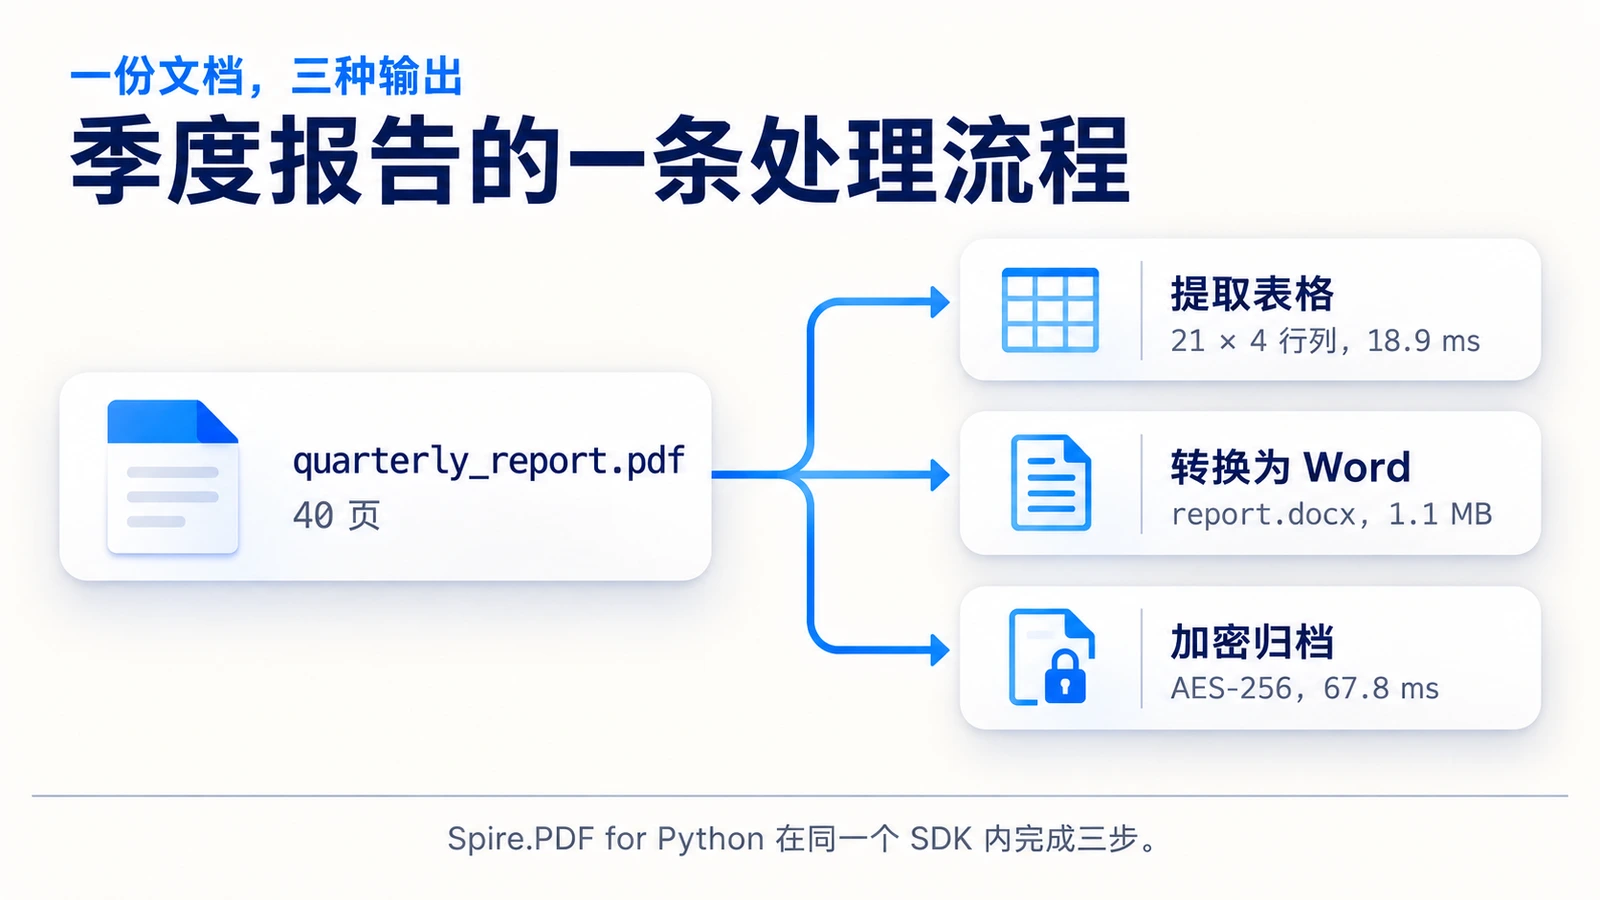
这组对比涵盖表格提取、删页、DOCX 与 PDF 生成、加密和耗时;DOCX 的版式还原不在本次计时对比范围内,转换结果请用自己的文件验证。耗时差异主要出在 DOCX 这一步,开源转换器大约用了 1.3 s。不过这个练习的重点不在秒表,而在代码的形态:一次导入,一个文档对象,包与包之间不用传文件。密码处理的更多细节见 Python 加密或解密 PDF 文档。
6. 性能与安装体积
下表所有数字均为预热 1 次后、10 次计时的中位数,单位为毫秒,括号内为最小值与最大值。每个数字都是该操作的端到端耗时:适用时包含打开夹具与保存输出。“n/a”表示该库没有对应的操作。
| 任务 | pypdf | pdfplumber | PyMuPDF | pikepdf | reportlab | Spire.PDF |
|---|---|---|---|---|---|---|
| 文本提取,10 页 | 43.1(39.9–46.1) | 320.4(295.5–573.8) | 7.2(6.7–8.4) | n/a | n/a | 58.2(53.8–64.6) |
| 表格提取,84 个单元格 | n/a | 44.6(42.3–53.7) | 363.4(341.6–385.7) | n/a | n/a | 18.9(16.2–26.4) |
| 旋转一页 | 9.2(8.5–13.1) | n/a | 3.8(2.7–11.0) | 6.4(5.6–7.7) | n/a | 22.4(20.6–29.9) |
| 删除一页 | 8.6(8.2–14.7) | n/a | 3.0(2.8–3.4) | 5.8(5.5–6.9) | n/a | 23.3(20.2–27.8) |
| 150 DPI 渲染 | n/a | n/a | 48.8(47.2–52.3) | n/a | n/a | 161.4(153.8–180.3) |
| AES-256 加密 | 19.6(17.2–24.6) | n/a | n/a | 32.0(30.9–34.4) | n/a | 67.8(62.1–72.2) |
| 生成 10 页 | n/a | n/a | n/a | n/a | 14.1(13.7–15.3) | 85.3(79.4–106.9) |
单项操作上,专用库在多数行里领先:文本、旋转、删除和渲染是 PyMuPDF,页面编辑是 pypdf,结构操作是 pikepdf,加密两者都可用,生成是 reportlab。Spire.PDF 中位数最低的是表格测试。生成测试的条件是 10 页、每页 40 行、A4、Arial 10 pt;渲染测试中两边输出的图片都是 1241 × 1754 像素。统一 SDK 的价值体现在组合流程里,而不是某一行单项数字上。
安装体积在干净的虚拟环境中测得,不含解释器、pip、setuptools、wheel 和 __pycache__:
| 目标 | 安装体积 | 包数 | 新进程导入 |
|---|---|---|---|
| pypdf | 1.8 MB | 1 | 219.9 ms |
| pypdf[crypto] | 13.2 MB | 4 | 331.8 ms |
| pdfplumber | 43.9 MB | 8 | 246.5 ms |
| PyMuPDF(默认) | 201.3 MB | 12 | 223.8 ms |
PyMuPDF(--no-deps) |
104.5 MB | 1 | 217.0 ms |
| pikepdf | 35.2 MB | 4 | 178.4 ms |
| reportlab | 20.4 MB | 3 | 9.0 ms |
| Spire.PDF | 70.5 MB | 2 | 640.6 ms |
| 三包工作流组合 | 388.9 MB | 29 | n/a |
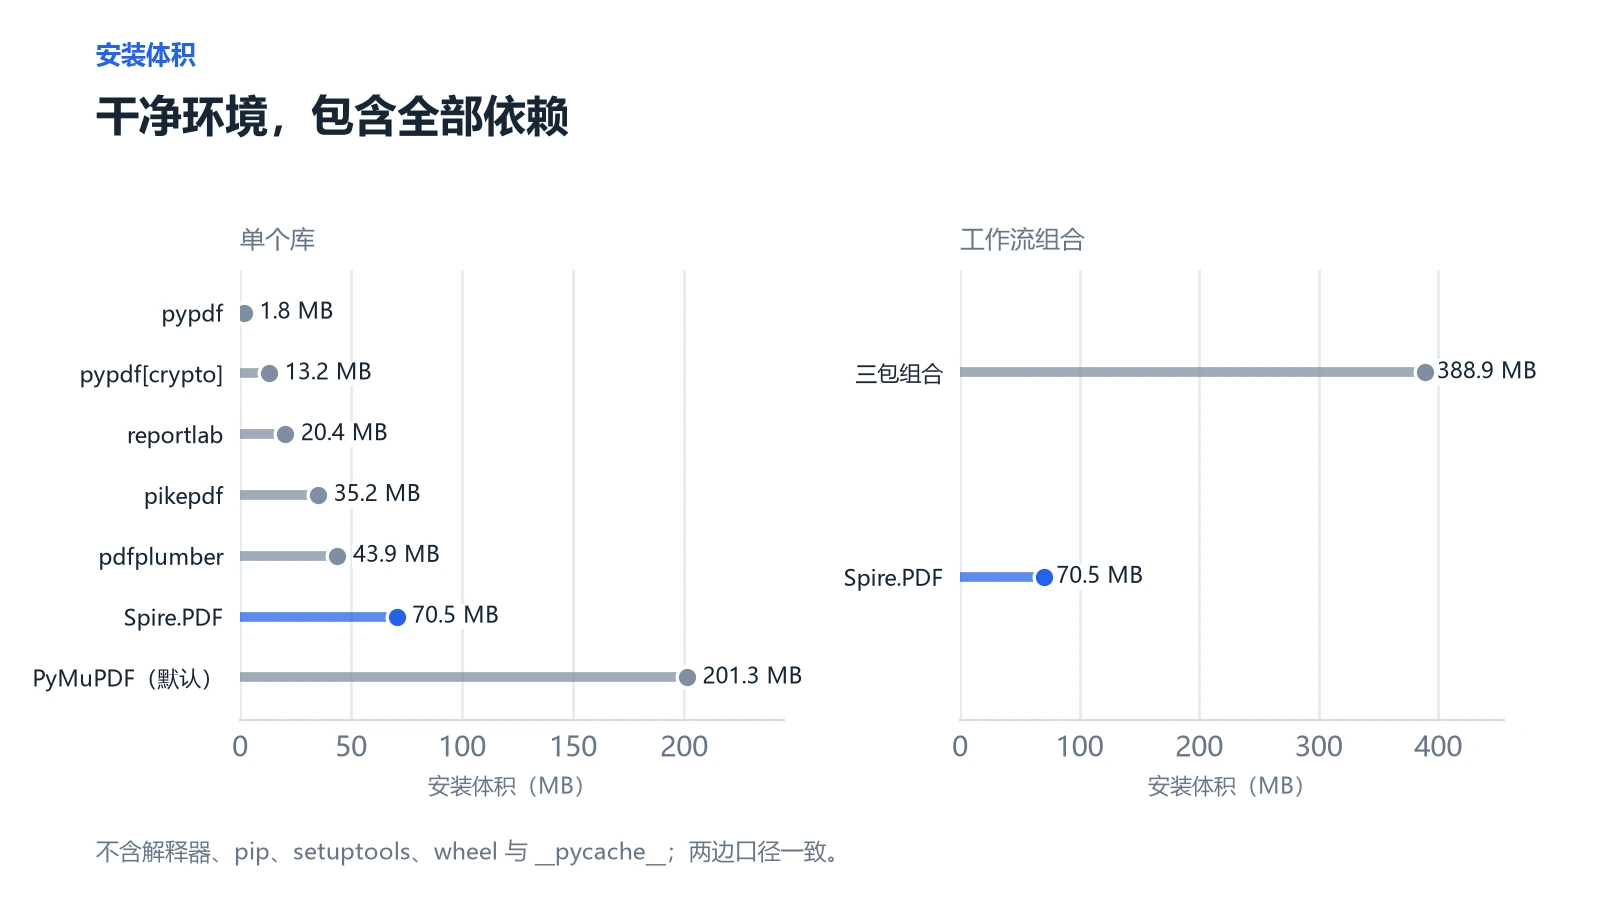
安装表里有两点值得细看。导入时间是每个进程只付一次的开销,对短生命周期的命令行任务和无服务器函数的影响,比对长期运行的服务更明显;Spire.PDF 的冷启动导入为 640.6 ms,仍在 1 秒以内;reportlab 最短,为 9.0 ms。安装体积则关系到容器镜像和桌面程序打包,PyMuPDF 默认的 201.3 MB 和三包组合的 388.9 MB 都比较突出。
授权逐项列出:pypdf 为 BSD-3,pdfplumber 为 MIT,PyMuPDF 为 AGPL-3.0 或商业授权,pikepdf 为 MPL-2.0,reportlab 为 BSD,Spire.PDF 为商业授权。AGPL 条款需要结合你的分发方式来评估。
7. 免费版、评估版、临时授权与商业授权
Spire.PDF 是商业产品,分为多个版本,各版本行为不同,所以在做基准测试或上线之前,先确认自己装的是哪个版本。
| 包 / 版本 | 状态 | 限制 |
|---|---|---|
| Spire.Pdf.Free 10.12.0(2025-01-16) | 免费版 | 输出最多 10 页;转图片、XPS、Word、HTML 仅限前 3 页 |
| spire-pdf 12.10.0(2026-10-12) | 评估版 | 显示评估警告;只处理前 10 页 |
| spire-pdf 12.10.0 | 临时授权(30 天) | 解除评估限制 |
| spire-pdf 12.10.0 | 商业授权 | 无上述限制 |
除了 API,商业授权也是一种维护关系。该包提供 Windows、Linux 和 macOS 的 wheel,2026 年 1 月至 10 月间发布了七个版本(12.1.3 到 12.10.0),商业授权包含更新与技术支持(论坛与邮件渠道),响应目标取决于授权类型。
页数上限很容易验证:把一份 40 页的文件放进评估版,实际只处理 10 页。这是评估版本身的限制,不代表产品能力,也是我们的 40 页工作流只报告开源方案数据的原因。评估版用于评测,不适合直接用于生产环境。第一次接触该产品的团队,比较稳妥的顺序是:先用评估版跑自己的文件,需要测试超过 10 页时申请临时授权,上线前再换成商业授权。
8. 为你的项目选对 PDF 库
大多数团队可以归入下面三种情形:
- 只有一类专门任务。 批量提取文本、渲染页面、合并文件或生成报表,就选为该操作而生的库,比如 PyMuPDF、pypdf 或 reportlab。如果要随产品分发,先看清授权。
- 以读取版面为主。 重点是表格和位置信息时,从 pdfplumber 入手,需要改页面再配 pypdf 或 pikepdf。
- 同一份文件上连续多个任务。 提取、改页、转换、加密属于同一条流水线时,一个统一的 SDK 可以减少需要维护的 API 和依赖树数量。Spire.PDF 的设计就是为这种情形,商业授权包含更新与支持。
定下来之前可以做一个小检验:把项目未来一年需要的所有操作都列出来,包括转换、加密和归档,再标出每项由哪个库负责。如果一个库就能覆盖整张清单,那就不用再选了;如果清单需要三个库,就拿三个依赖的维护成本去和一份授权的费用比一比。
数一数任务,而不是比功能。如果项目需要的操作一句话就能说完,且只有一两项,专用库大概就够了;如果清单越列越长,不妨用自己的文件试试 Spire.PDF for Python,并参阅 Spire.PDF for Python 教程集合。
9. 常见问题
哪个 Python PDF 库整体最好?
没有唯一答案。PyMuPDF 在文本和渲染速度上领先,pypdf 是页面操作的简单选择,pdfplumber 适合表格,reportlab 适合生成。要串联多个任务的流水线,Spire.PDF 这类统一 SDK 可以减少直接集成的 PDF 包数量。
pypdf 和 PyMuPDF 该选哪个?
需要页面操作、希望包小且是纯 Python、授权为 BSD,选 pypdf。需要更快的文本提取和页面渲染,选 PyMuPDF,但先确认它的 AGPL-3.0 或商业授权条款。本次测试中,PyMuPDF 提取文本用时 7.2 ms,pypdf 为 43.1 ms。
怎样在 Python 中提取 PDF 里的表格?
对带边框的表格,可以用 pdfplumber 的 extract_tables(),也可以用 PyMuPDF 或 Spire.PDF 的表格提取功能。在我们的 21 × 4 测试文件上,三者都对上了全部 84 个单元格。无边框或含合并单元格的表格需要另行测试。
Python 能把 PDF 转成 Word 吗?
可以。pdf2docx 是常见的开源方案,Spire.PDF 也能把已加载的文档保存为 DOCX。转换结果取决于源文件的版面,用于生产前请先拿有代表性的文件验证。
这些库可以免费商用吗?
pypdf、pdfplumber、pikepdf 和 reportlab 采用宽松或弱 copyleft 许可(BSD-3、MIT、MPL-2.0、BSD)。PyMuPDF 为 AGPL-3.0 或商业授权,需要按你的分发方式评估。Spire.PDF 用于生产需要商业授权;商业授权包含更新与技术支持,免费版和评估版有页数限制。
10. 测试说明
披露: Spire.PDF for Python 是 E-iceblue 的产品,本次基准测试由发布方完成。为此我们公开了测试夹具、版本和方法,开源库在完全相同的文件上测试。
- 环境: Windows 11,Intel Core i3-10105 @ 3.70 GHz(4 核 8 线程),8.4 GB 内存,Python 3.14.6。
- 版本: pypdf 6.21.4、pdfplumber 0.11.10、PyMuPDF 2.1、pikepdf 10.17.0、reportlab 5.1.0、pdf2docx 0.5.13、python-docx 1.2.0、Spire.PDF 12.10.0。
- 夹具: 一份 10 页文本文档、第一页带边框的 21 × 4 表格、一份中文发票、一页用于渲染的混合内容页,以及生成的 10 页和 40 页季度报告。页数、大小和 SHA-256 记录在夹具清单中。
- 计时: 每项测试预热 1 次、正式测量 10 次,报告中位数及最小、最大值。打开、操作、保存分段计时。
- 正确性: 文本用唯一词覆盖率和序列相似度比较(不用字符数,因为各库的空白处理约定不同);表格逐个单元格比较;加密文件用密码重新打开,并检查无密码时是否被拒绝。
- 未覆盖: 仅为单机、单一工作负载;扫描文档、OCR、签名、表单处理、含合并单元格的表格和任意损坏文件均未测量。换成你的硬件和文档,耗时会有差异。
资料来源